Innehållsförteckning
- Vad kostar ChatGPT, Claude och Gemini via API?
- En dyrare AI-modell kan bli billigare per uppgift
- Tänkandenivån kan påverka kostnaden lika mycket som modellen
- Vilken AI-modell ska man välja via API?
- Hur räknar man ut vad AI kostar via API?
- Hur sänker man kostnaden för AI via API?
- Är ett AI-abonnemang billigare än API?
- Kan man testa AI via API gratis?
Via API betalar du för AI per token, alltså per ordbit som språkmodellen läser eller skriver. När detta skrivs i september 2026 kostar de senaste modellerna från OpenAI, Anthropic och Google mellan $0,10 och $10 per miljon tokens du skickar in och mellan $0,50 och $50 per miljon tokens som modellen skriver tillbaka. Tokenpriset säger ändå förvånansvärt lite om vad en uppgift kostar, eftersom modellerna gör av med väldigt olika många tokens för att komma fram till ett svar.
Vad kostar ChatGPT, Claude och Gemini via API?
Alla tre leverantörerna tar betalt per miljon tokens, där en token är en bit av ett ord. Anthropic anger att en token motsvarar ungefär 0,75 ord på engelska men att det skiljer sig mellan språk. Du betalar ett pris för det du skickar in och ett annat för det modellen skriver tillbaka. Det modellen skriver kostar oftast fem gånger mer.
Det beror på att modellen kan räkna igenom allt du skickar in på en gång, men måste skriva svaret en token i taget. För varje ny token gör den en hel ny beräkning genom modellen där den väger in alla tokens som kommit före. Nästa token kan inte påbörjas förrän den förra är klar.
Priserna gäller bara API:et, för en prenumeration eller licens som ChatGPT Plus eller Claude Pro är en egen produkt med ett fast pris i månaden som faktureras separat.
Listpriser per miljon tokens
| Modell | In | Ut |
|---|---|---|
 OpenAI | ||
| GPT-6 Astra Mycket stark och sparsam, men ojämn | $10 | $50 |
| GPT-6 Sol Mest förmåga för pengarna i mellanklassen | $2 | $10 |
| GPT-6 Luna Extremt billig, men kontrollera fakta | $0,10 | $0,50 |
 Anthropic | ||
| Claude Fable 5.1 Pålitlig och stark, men sällan värd priset | $10 | $50 |
| Claude Opus 5.5 Bäst i mätningen, men gör av med många tokens | $4 | $20 |
| Claude Sonnet 5 Varken billig, snabb eller tillräckligt smart | $2 | $10 |
| Claude Haiku 4.5 Snabb, men svag i dagens jämförelser | $1 | $5 |
 Google | ||
| Gemini 3.1 Pro 1 Förhandsversion som är svag på agentarbete | $2 | $12 |
| Gemini 3.8 Flash 2 Billig och snabb, men pratig | $0,75 | $3,75 |
Vad kostar ChatGPT API?
ChatGPT API är det namn många använder för OpenAI:s API, där GPT-6 är den senaste familjen av modeller. Priserna i tabellen gäller så länge du skickar in mindre än 272 000 tokens åt gången. Skickar du in mer blir det dubbelt så dyrt att skicka in och 50 procent dyrare att få svar. Vill ni att allt ska behandlas inom EU går det att ordna, men det kräver ett godkännande från OpenAI och kostar 10 procent mer.
Vad kostar Claude API?
Hos Anthropic kostar varje token lika mycket oavsett hur mycket du skickar in åt gången, upp till en miljon tokens. Fable 5.1, Opus 5.5 och Sonnet 5 räknar däremot samma text som ungefär 30 procent fler tokens än äldre Claude-modeller, enligt Anthropic. Ett lägre pris per token betyder därför inte automatiskt en lägre kostnad jämfört med OpenAI och Google. Vill ni att datan behandlas inom EU går det inte via Anthropic själva när detta skrivs, bara via Amazon eller Google, där det kostar 10 procent mer.
Vad kostar Gemini API?
Priset för Gemini 3.8 Flash i tabellen är ett introduktionspris som gäller till den 31 december 2026. Därefter blir det dubbelt så dyrt, $1,50 per miljon tokens in och $7,50 ut. Gemini 3.1 Pro är fortfarande en testversion som Google släppte i februari. Den blir dessutom dyrare när du skickar in mer än 200 000 tokens åt gången. Låter du modellen söka på Google ingår 5 000 sökningar i månaden, sedan kostar varje 1 000 sökningar $14.
En dyrare AI-modell kan bli billigare per uppgift
Vad en uppgift kostar beror både på priset per token och på hur många tokens modellen gör av med för att lösa den. Hur många tokens modellerna gör av med kan skilja flera gånger om. En modell som tänker kortare och hittar rätt svar snabbare kan därför bli billigare per uppgift än en modell med halva tokenpriset. Det är lätt att fastna på tokenpriserna när man jämför modeller, men det är kostnaden per uppgift som syns på fakturan.
Tydligast syns det i mätningarna från Artificial Analysis, som låter modellerna lösa samma uppgifter och visar både vad varje uppgift kostade och hur många poäng modellerna får i det som kallas Intelligence Index. Låter man modellerna tänka lika mycket, på nivån hög, gör Gemini 3.8 Flash av med nästan sju gånger så många tokens som GPT-6 Sol för att ta sig igenom testerna. Trots det lägre tokenpriset kostar en uppgift $1,24 med 3.8 Flash och $0,37 med Sol, som dessutom får högre poäng. Siffran för 3.8 Flash bygger på dagens introduktionspris, som dubblas vid årsskiftet. Samma mönster finns hos Anthropic. Claude Sonnet 5 har halva tokenpriset jämfört med Opus 5.5 men gör av med fler tokens, så en uppgift kostar ungefär lika mycket, $1,79 mot $1,82, medan Opus får betydligt högre poäng.
Tokenåtgång för samma test
- GPT-6 Sol 25 miljoner
- GPT-6 Astra 26 miljoner
- GPT-6 Luna 47 miljoner
- Claude Opus 5.5 53 miljoner
- Claude Fable 5.1 62 miljoner
- Gemini 3.1 Pro 67 miljoner
- Claude Haiku 4.5 78 miljoner
- Claude Sonnet 5 89 miljoner
- Gemini 3.8 Flash 170 miljoner
Poäng och kostnad per uppgift
Vi på Scribill ser samma sak när vi använder modellerna själva. Dyrare modeller ger inte sällan billigare resultat, eftersom de når målet snabbare och gör av med färre tokens på vägen. Är uppgiften väldigt enkel kan den billigaste modellen fortfarande vara det bästa valet.
Kostnaden är inte heller alltid det viktigaste. Har du höga krav på resultatet kan en stark modell nå dit på två, tre vändor, medan en svagare modell kanske aldrig gör det hur länge du än håller på. Claude Haiku 4.5 får 17 poäng i mätningen, medan Fable 5.1 får 49 redan på medelnivå.
Den här typen av tester ska ändå läsas med förbehåll. Testerna görs på engelska med tyngdpunkt på kod, agentarbete och kunskapsuppgifter. Vi ser också att en del modeller ser bättre ut i testerna än när man använder dem i vardagen.
Tänkandenivån kan påverka kostnaden lika mycket som modellen
De nya modellerna tänker innan de svarar. Hur mycket väljer du själv via API:et, från låg till högsta nivå. Tänkandet kostar lika mycket som svaret hos alla tre leverantörerna, eftersom det räknas som tokens modellen skriver, även om du aldrig ser det. En högre nivå gör därför ofta uppgiften flera gånger dyrare. Samma tokens avgör också hur mycket el uppgiften drar, som vi räknar på i artikeln om hur AI påverkar miljön.
Poängen ökar däremot mycket långsammare än kostnaden. Går Claude Opus 5.5 från hög till högsta nivå i Artificial Analysis mätning får den fyra poäng till för drygt tre gånger så hög kostnad per uppgift. GPT-6 Astra får på samma sätt två poäng till för nästan dubbla kostnaden. Över hög lönar det sig sällan, varken hos OpenAI eller Anthropic. En låg nivå är samtidigt inte alltid dålig. GPT-6 Astra på låg nivå får högre poäng än Claude Sonnet 5 på högsta, för en sjättedel av kostnaden.
Poäng och kostnad per tänkandenivå
Själv kör jag oftast medel eller hög, både med Claude och med ChatGPT, eftersom jag hellre jobbar i fler vändor än lägger förbrukningen på den högsta nivån. Samma tänk gäller via API:et. Lägger man ihop modeller och nivåer är det få kombinationer som ger mest poäng för pengarna. I mätningen är det GPT-6 Luna och Sol i den billigare änden, GPT-6 Astra på låg nivå och Claude Opus 5.5 från medelnivå och uppåt. Fable 5.1, Sonnet 5, Haiku 4.5 och Gemini-modellerna får i den här mätningen alltid mindre för pengarna än någon av dem.
Vilken AI-modell ska man välja via API?
Via API kan du välja modell för varje uppgift och blanda leverantörer fritt, så valet handlar mer om vad modellen ska göra än om vilken leverantör du har avtal med. Claude Opus 5.5 kan till exempel styra arbetet och låta billiga Luna-agenter göra researchen.
Hos Anthropic hade vi inte valt något under Opus 5.5. Sonnet 5 och Haiku 4.5 är för svaga för vad de kostar, medan Opus 5.5 i många fall blir billigare per färdig uppgift än Sonnet, även för något så enkelt som research. Fable 5.1 är stark och pålitlig men sällan värd merkostnaden via API, eftersom Opus 5.5 får högre poäng för mindre än hälften av kostnaden per uppgift.
Hos OpenAI har hela GPT-6-familjen en plats, eftersom modellerna gör av med få tokens. Luna är den billigaste modellen i jämförelsen, både per token och per uppgift. Den passar stora volymer och enkla uppgifter, men har lätt att hitta på svar i Artificial Analysis faktatest och behöver kontrolleras. Sol räcker för det mesta medan Astra tar sig an det svåraste, där den når samma poäng som Fable 5.1 för mindre än hälften av kostnaden.
Googles Gemini-modeller har vi använt mindre än de andra, men de kan vara värda att titta på för att skriva texter. För programmering eller agentarbete hade vi inte lagt pengarna där när detta skrivs.
Hur räknar man ut vad AI kostar via API?
Kostnaden räknar du ut genom att ta antalet tokens du skickar in gånger priset för dem, lägga till antalet tokens modellen skriver gånger priset för dem och sedan dela med en miljon. Tänkandet räknas som tokens modellen skriver, så en modell som tänker skriver betydligt fler tokens än det svar du ser.
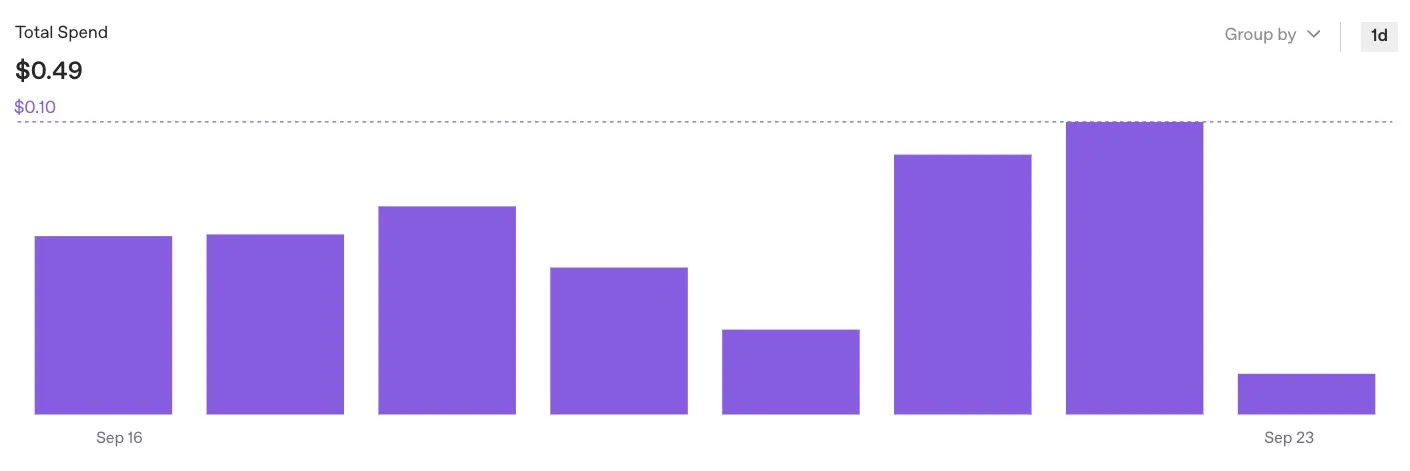
Vår egen promptgenerator används ofta och kör en av OpenAI:s minsta modeller, som får tre frågor för varje prompt generatorn tar fram. En färdig prompt gör i snitt av med omkring 6 700 tokens in och 10 000 tokens ut. Med modellens pris på $0,20 och $1,20 per miljon tokens blir det drygt en cent per prompt, ungefär 13 öre med dollarkursen den 23 september 2026. Samma mängd tokens hade kostat ungefär 40 gånger mer med GPT-6 Astra. En hel vecka i september kostade promptgeneratorn oss $0,49 totalt.
Hur sänker man kostnaden för AI via API?
Rätt modell och rätt tänkandenivå påverkar kostnaden mest. Därefter kommer hur du delar upp arbetet, så att modellen inte får läsa mer än uppgiften kräver. Små uppgifter som inte hänger ihop, som att sortera ärenden eller kategorisera texter, kan skickas var för sig i en ny konversation, så att du inte betalar för att en gammal konversation följer med. Uppgifter i flera steg som bygger på varandra behöver däremot samma konversation, där cachning gör stor skillnad.
Ett arbetssätt jag själv använder i Codex och i ChatGPT är att låta GPT-6 Astra styra arbetet och skicka ut Luna-agenter på hög tänkandenivå. De letar information i var sitt spår och flaggar det de är osäkra på, innan Astra dubbelkollar det som flaggats. Den stora modellen behöver då bara arbeta igenom en sammanfattning i stället för allt agenterna har läst. Samma upplägg fungerar när du bygger något själv via API:et.
Cachning betyder att leverantören sparar sådant du skickar med varje gång, som långa instruktioner eller ett dokument, så att det inte behöver läsas in på nytt. Det som redan ligger sparat kostar då ungefär en tiondel av det vanliga priset hos alla tre leverantörerna och ännu mindre med Opus 5.5 och Fable 5.1. Uppgifter som inte behöver svar direkt kan i stället skickas i klump, så kallad batch, som alla tre leverantörerna tar halva priset för mot att svaren kommer senare.
Cachning spelar extra stor roll i programmeringsverktyg som Claude Code, Codex, OpenCode och Pi när du betalar per token i stället för med ett abonnemang. Verktygen skickar med hela konversationen och alla filer i varje nytt steg. Anthropic beskriver att Claude Code då betalar det lägre cachepriset för det som redan har skickats. Att spara något i cachen kostar 25 procent mer första gången hos både Anthropic och OpenAI, men varje gång det används igen kostar det en tiondel eller mindre. En lång arbetsdag i ett sådant verktyg blir därför betydligt billigare när cachen fungerar.
Är ett AI-abonnemang billigare än API?
För den som själv använder AI mycket, i chatten eller i verktyg som Codex och Claude Code, är ett abonnemang oftast billigare än att betala per token. Leverantörerna ger betydligt mer användning i abonnemangen än samma pengar räcker till via API:et, medan API:et är till för att bygga in AI i egna tjänster och flöden.
Analysföretaget SemiAnalysis körde abonnemangen till gränsen med långa programmeringsuppgifter och räknade om användningen till API-priser. ChatGPT Pro för $200 i månaden gav då motsvarande omkring $14 000 och Claude Max för samma pris omkring $8 000. Det är ett stresstest och inte vanlig användning, men det visar hur stor skillnaden kan vara. Anthropic anger själva att en utvecklare som kör Claude Code via API i snitt gör av med omkring $150 till $250 i månaden, men där håller vi inte med. Den som använder modellerna flitigt lär snarare komma upp i det fyrdubbla.
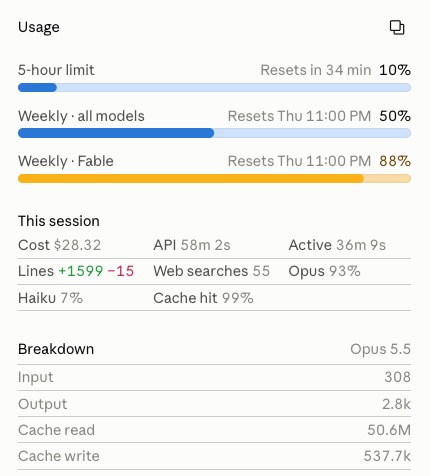
En enda session i Claude Code när vi arbetade med den här artikeln hade kostat $28,32 till API-pris, men ingick i vårt abonnemang. Nästan allt var cacheläsningar, över 50 miljoner tokens, vilket visar hur mycket cachningen betyder i sådana verktyg.
Kan man testa AI via API gratis?
Gemini API har en gratisnivå för bland annat Gemini 3.8 Flash men inte för 3.1 Pro, medan Anthropic ger nya konton en liten summa att testa för. Gratisnivån hos Google har ett villkor som är lätt att missa. Det du skickar in där får Google enligt sin prissida använda för att förbättra sina produkter. Enligt villkoren får dessutom tjänster som riktar sig till användare i EES bara använda den betalda nivån. För att prova själv fungerar gratisnivån bra, men inget från jobbet bör skickas in där.
Funderar ni på hur AI ska byggas in i era flöden och vilka modeller som passar till vad? Läs om hur vi hjälper till med AI-strategi.

Jimmi Ask är en av grundarna av Scribill och utbildar svenska företag i Copilot, ChatGPT, Claude och Gemini. Mer om oss →